视频转字幕
使用语音识别模型听取原视频,生成带时间的字幕;可选择已接入的本地或云端模型。
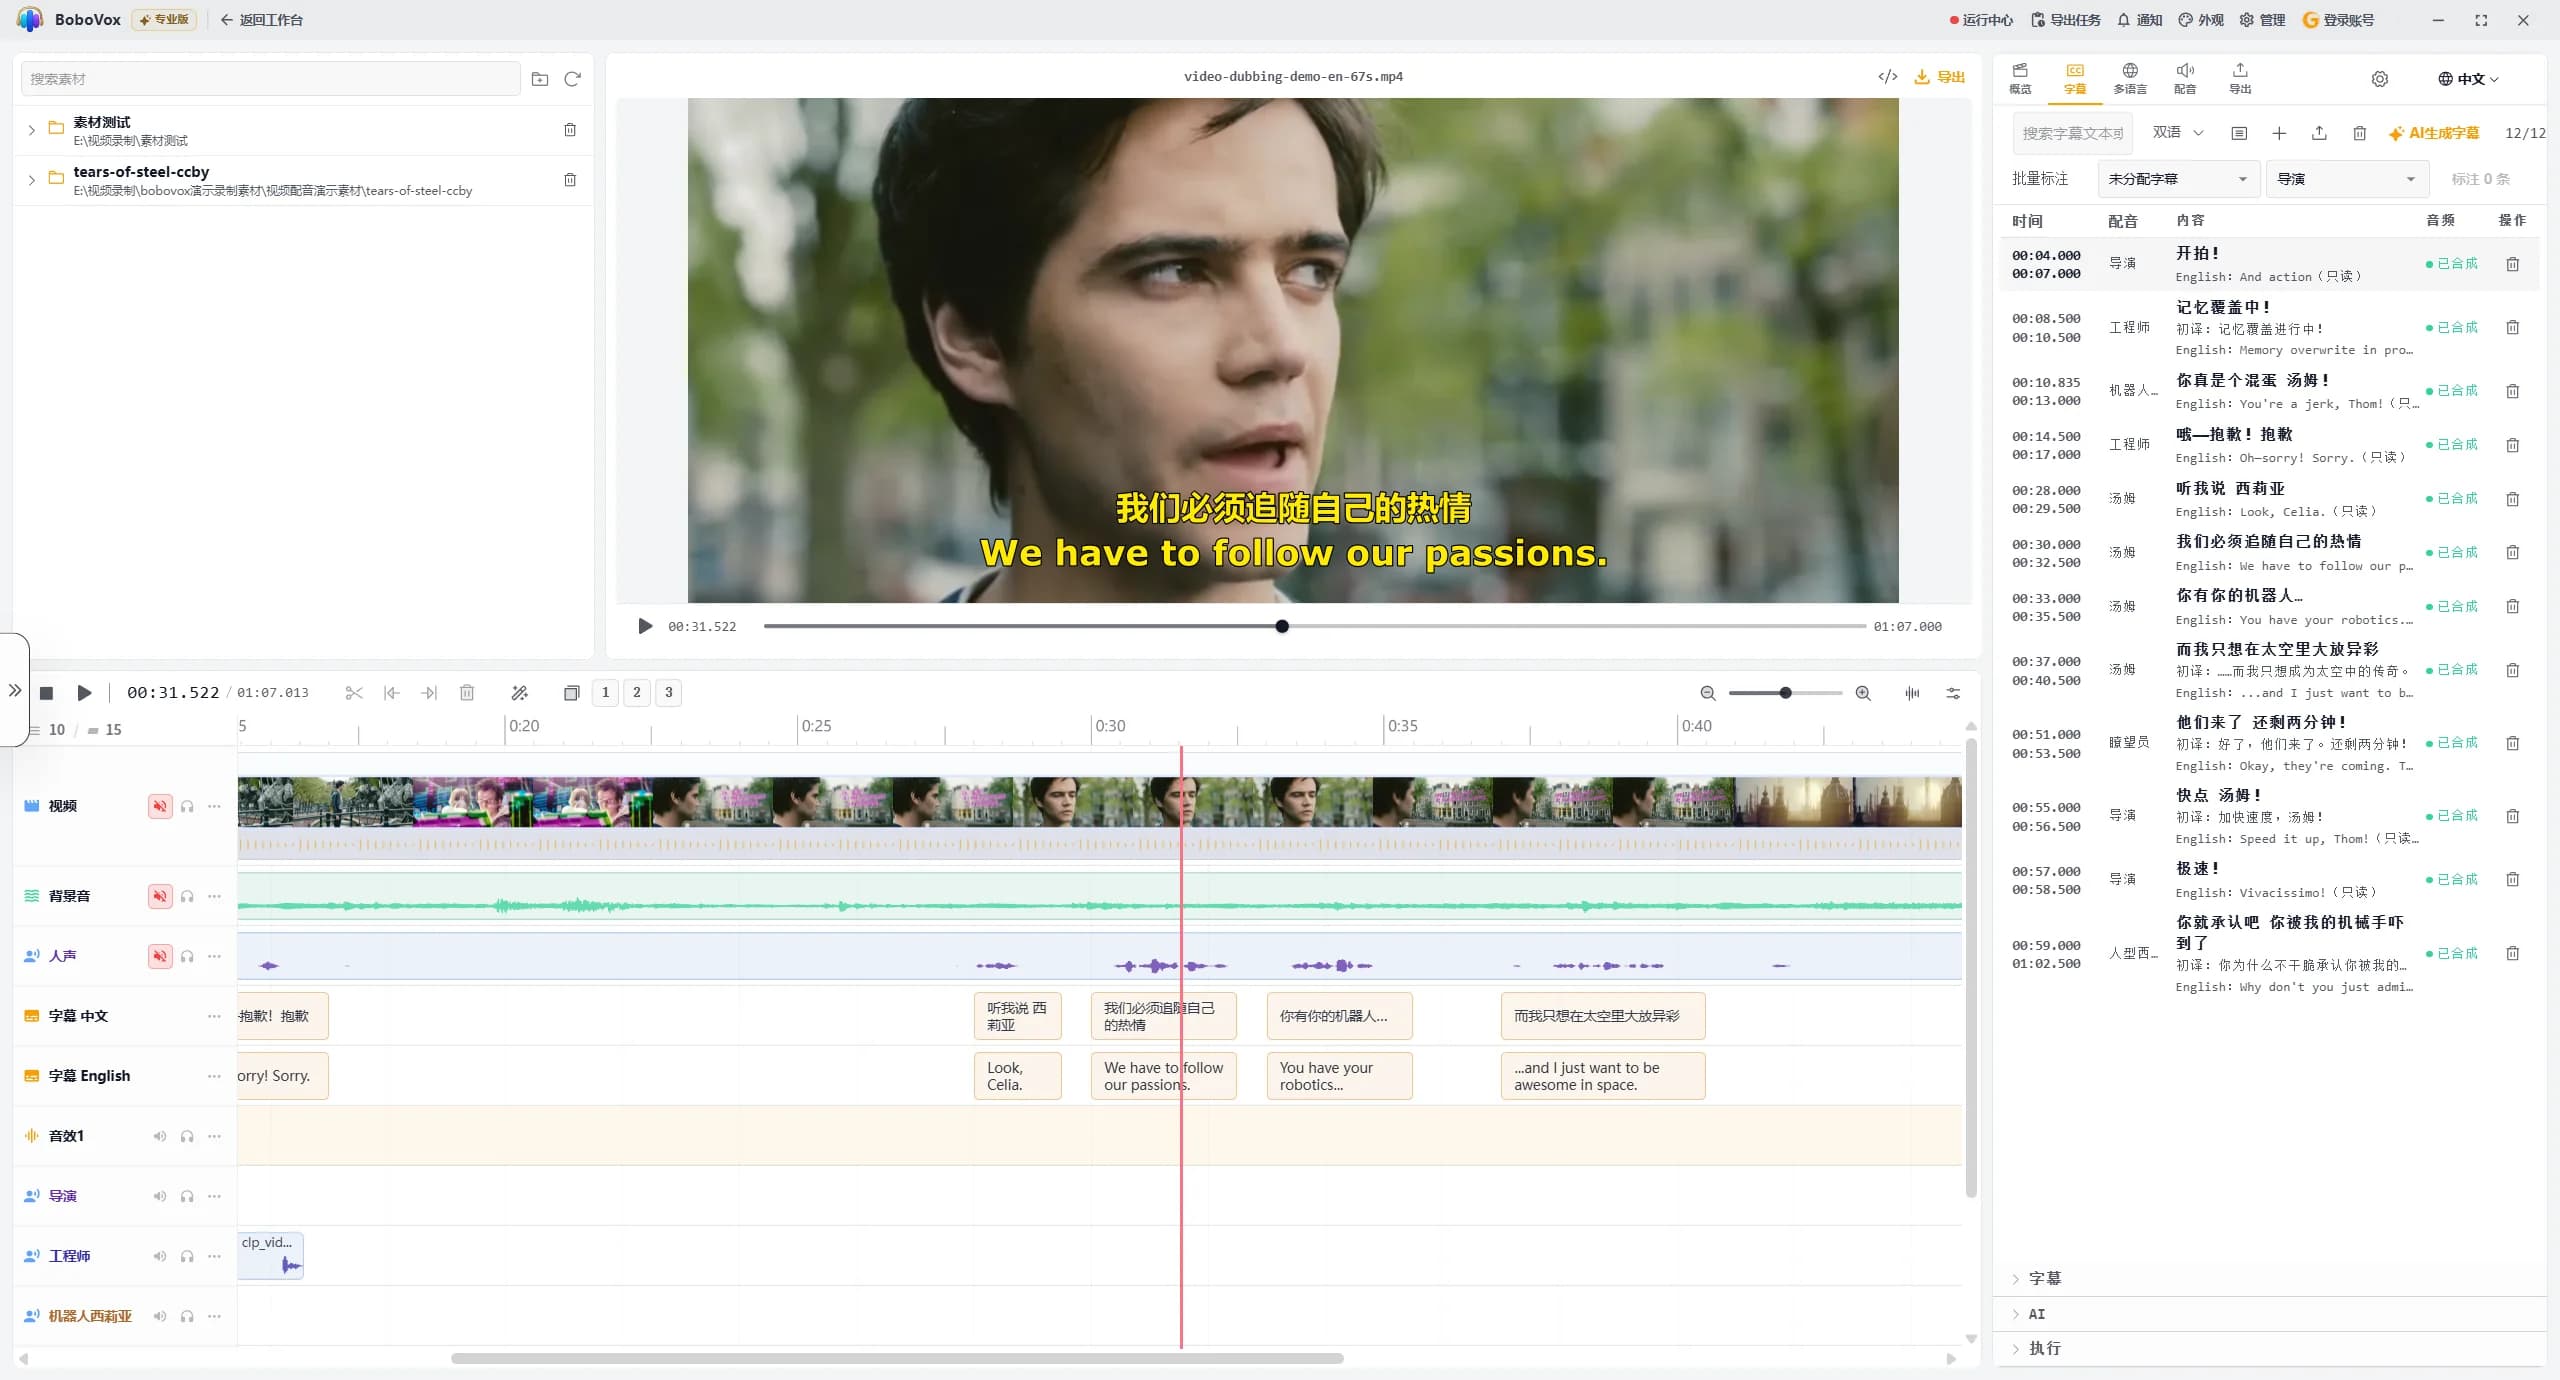
在一个工程里完成视频转字幕、翻译、多人角色配音、原声处理和成片导出;需要的环境音、剧情音效和 BGM 既能使用本地素材,也能用 AI 生成。
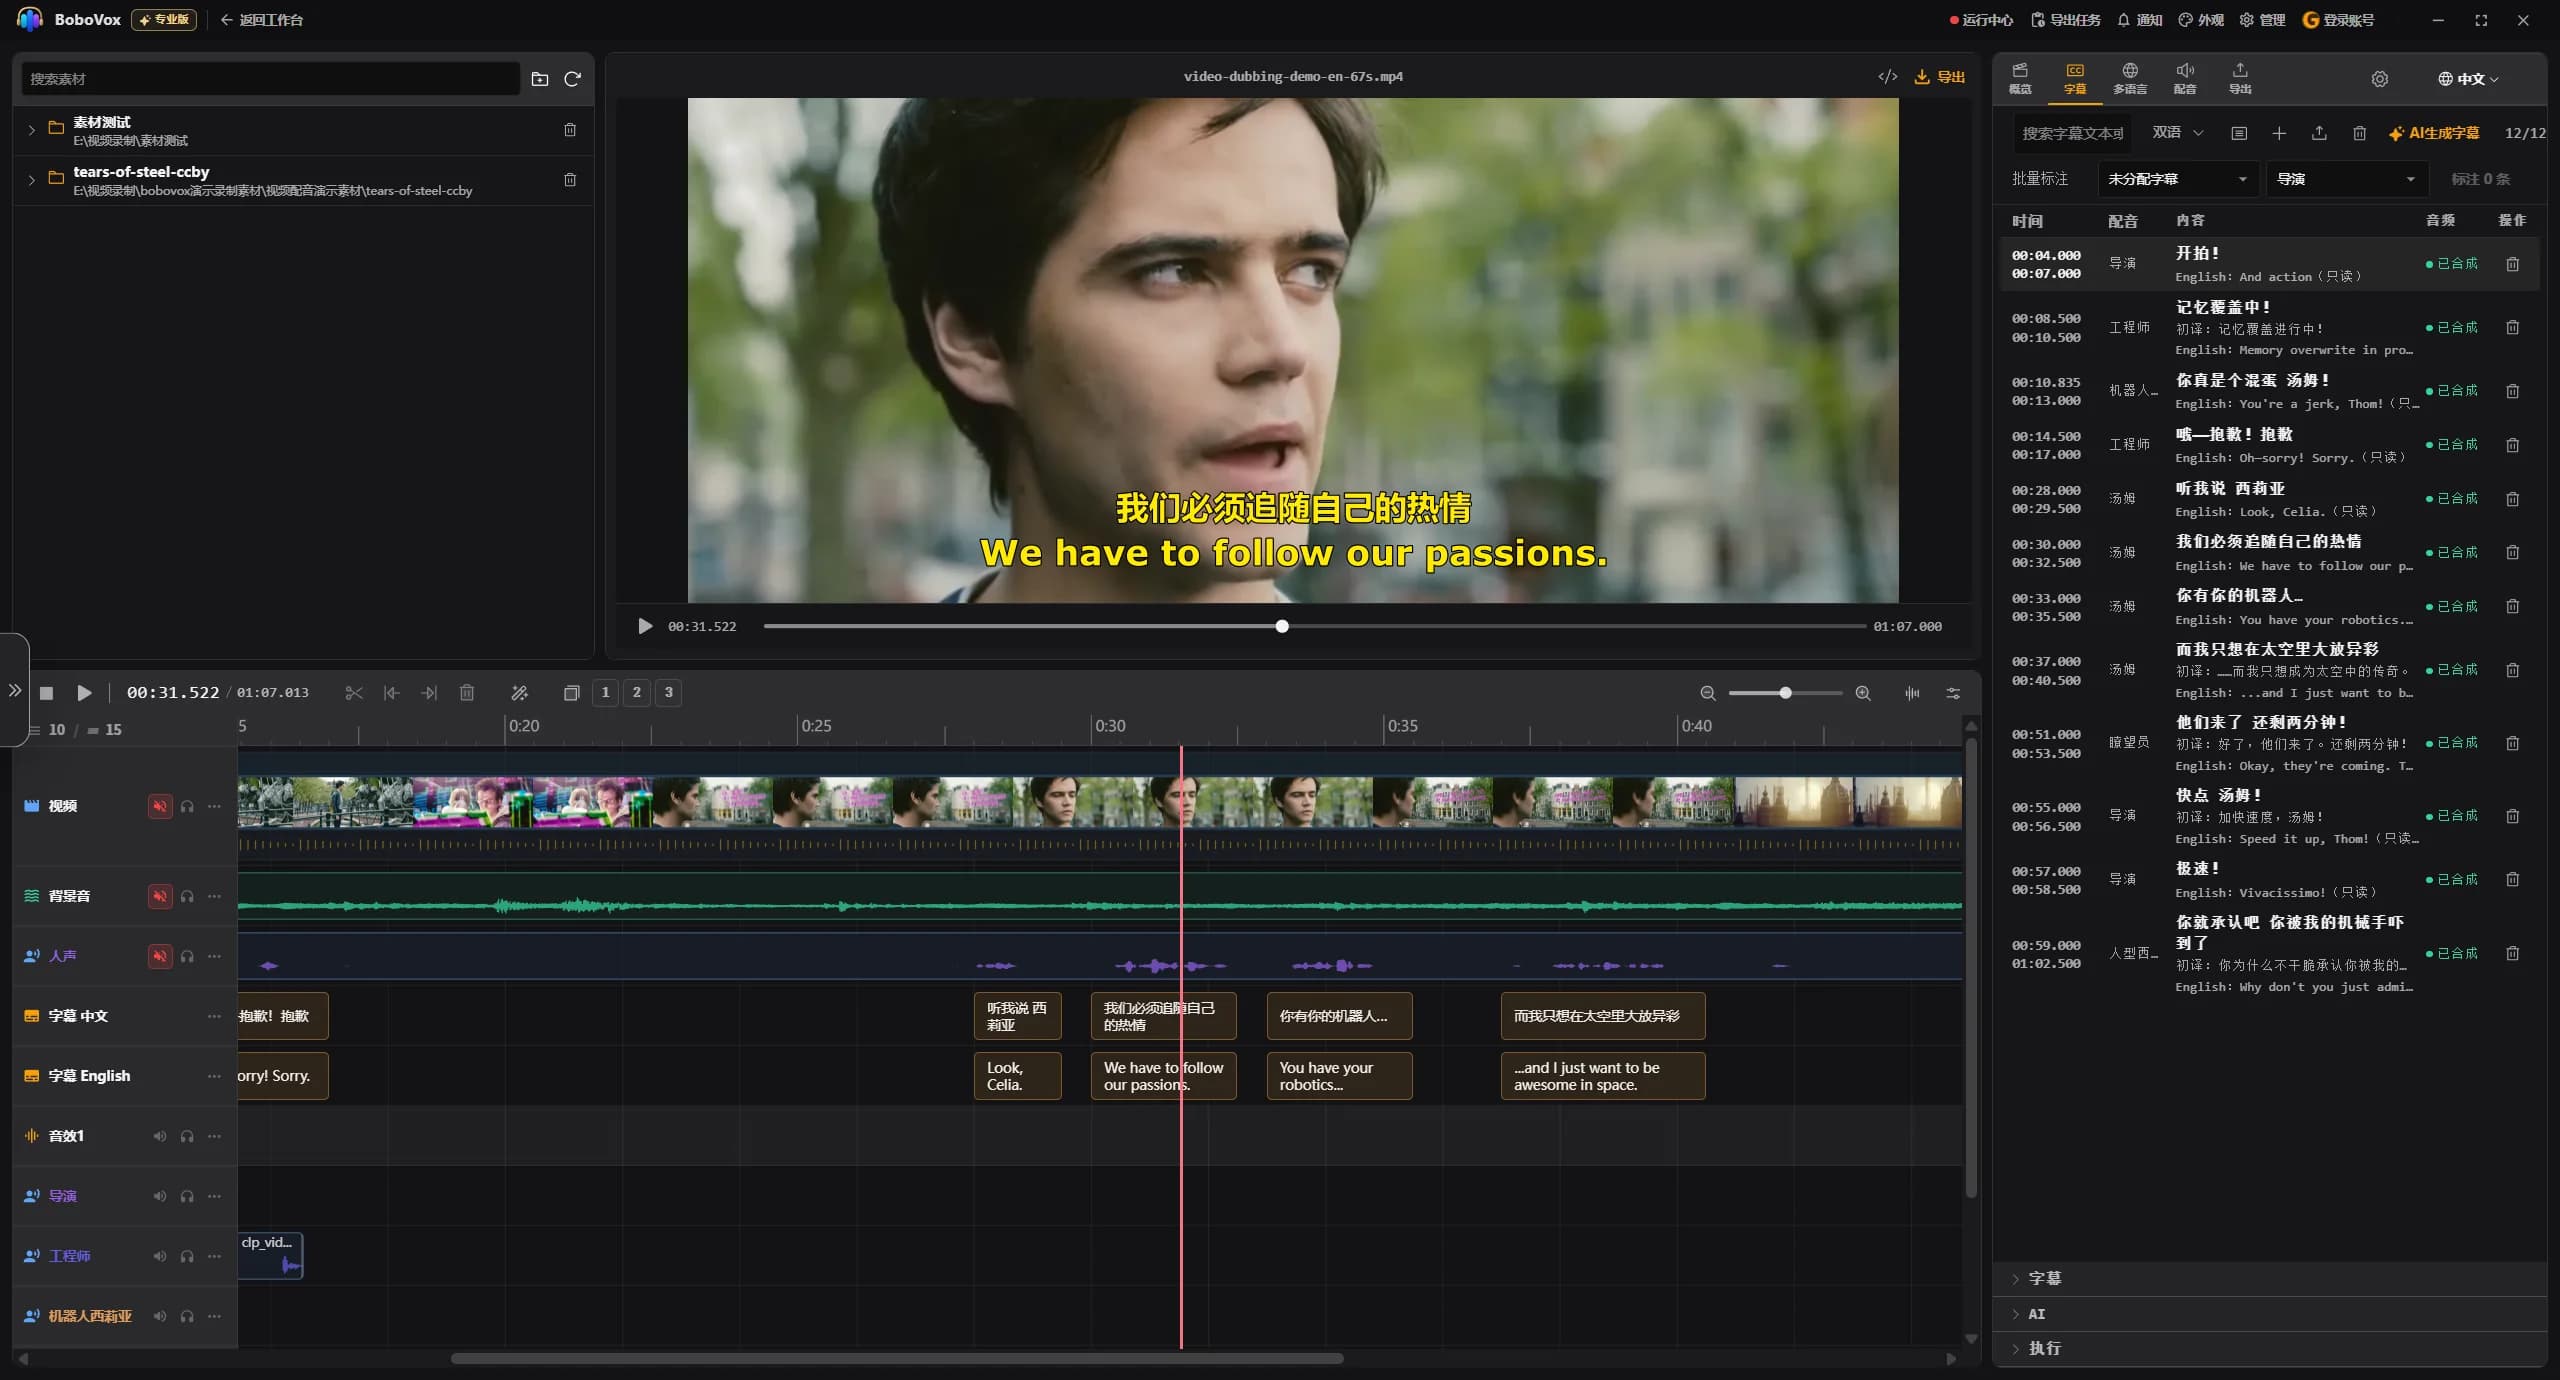
把原视频中的话整理成字幕,再为旁白和人物制作新配音。
使用语音识别模型听取原视频,生成带时间的字幕;可选择已接入的本地或云端模型。
根据可编辑字幕,为视频旁白和不同人物生成新的配音。
修改文字、分段和出现时间,支持多处直接编辑。
使用已配置的内容模型,把原字幕翻译成一个或多个目标语言。
在画面中同时显示两种语言,并调整上下顺序。
设置字体、字号、字重、颜色、描边、背景和位置。
导出 ASS、SRT、WebVTT 或 LRC,可一次选择多种格式。
给旁白和不同人物选好声音,再逐句或批量完成配音。
给不同人物分配角色,并为每个角色绑定音色。
单独试听、修改和重新生成某一句。
按角色和音色一次生成所有待处理台词。
检查配音时长,并通过文本或语速匹配视频节奏。
从本地模型、云端供应商和系统声音中搜索、筛选并试听音色,再固定给对应角色。
用同一原片制作不同语言的字幕、声音和成片。
专业版可翻译字幕,并制作目标语言配音、字幕和成片。
在同一工程中建立多个目标语言版本。
组合显示或单独导出不同语言字幕。
批量处理多个语言版本的字幕和配音。
一次输出不同语言的成片和字幕文件。
决定原视频里的人声、音乐和现场声音怎么保留、分开或替换。
把原视频中的人物讲话和背景声音分开。
替换原对白,同时保留音乐、环境声和现场音效。
将分离后的背景声音作为独立音频继续使用。
让完整原声继续参与最终混音。
关闭全部原声,只使用新配音和新增声音。
既能使用本地素材,也能用 AI 补充环境、音效和背景音乐。
导入自己的 BGM,或通过已接入的音乐模型生成,再调整时间、音量和淡入淡出。
使用本地素材,或用 AI 生成动作声、提示声、转场声等剧情音效。
使用本地素材,或用 AI 生成街道、房间、风雨等持续环境声。
在时间线上选好一个位置和时长,用一句话生成人声、环境音、剧情音效或 BGM。
专业版可一次处理多个时间线位置或多个声音生成任务,适合集中完成声音制作。
通过 BoboGen 运行已接入的本地音效和音乐模型,在自己的设备上完成生成。
把新配音、原声、背景音乐、环境音和音效放在不同轨道上调整整体听感。
把画面、声音和字幕组合成需要的交付版本。
导出音频、视频成片和字幕文件。
选择烧录字幕、内嵌字幕或外挂字幕。
专业版可一次输出不同语言、配音和字幕组合。
一次导出多种字幕文件,不重复配置。
先让模型听懂原视频,再把字幕、角色和声音整理到同一个工程里。
展开查看使用已接入的本地或云端识别模型,把视频里的对话变成带时间的字幕。
专业版需要多语言版本时,可使用已配置的内容模型翻译字幕,再由用户检查和修改。
给不同人物绑定本地模型、云端服务或系统声音,逐句试听;也可以按角色批量生成待处理台词。
根据画面和字幕时间调整文字、语速和片段位置,让新配音更贴合视频节奏。
新配音只是其中一层。原声、环境、音效和背景音乐都可以分开处理。
展开查看可以保留完整原声,也可以分离人物讲话和背景声音,替换对白时保留现场氛围。
导入自己的环境音、动作音效、转场声和 BGM,直接放进时间线。
缺少素材时,可以生成环境音、剧情音效和 BGM,再试听、替换或继续剪辑。
BoboGen 可以运行已接入的本地音效和音乐模型,在自己的设备上完成相应生成任务。
BoboVox 负责把工作流程组织起来,具体使用本地模型还是云端服务,由用户按效果、成本和设备情况决定。
展开查看已经部署的本地语音、识别、音效或音乐模型,可以直接参与字幕、配音和声音制作。
需要其他语言、音色或模型能力时,可以配置相应供应商账号和 API Key。
不同模型支持的语言、音色、情绪和控制方式不同,客户端只显示当前可用能力。
无论声音来自本地素材、本地模型还是云端服务,进入工程后都能继续对齐、混音和导出。
官网不提供在线模型调用额度。云端服务由用户自行配置,本地模型在用户设备上运行。
从短文本、长稿件到多人声音作品,使用角色、音色、音效和多轨编辑继续制作。